Quando a IA cai: fallback, MCP e continuidade nas empresas
Se o seu provedor de IA ficar indisponível agora, quais processos da sua empresa continuam funcionando? Fallback, MCP, estado e planos de continuidade.
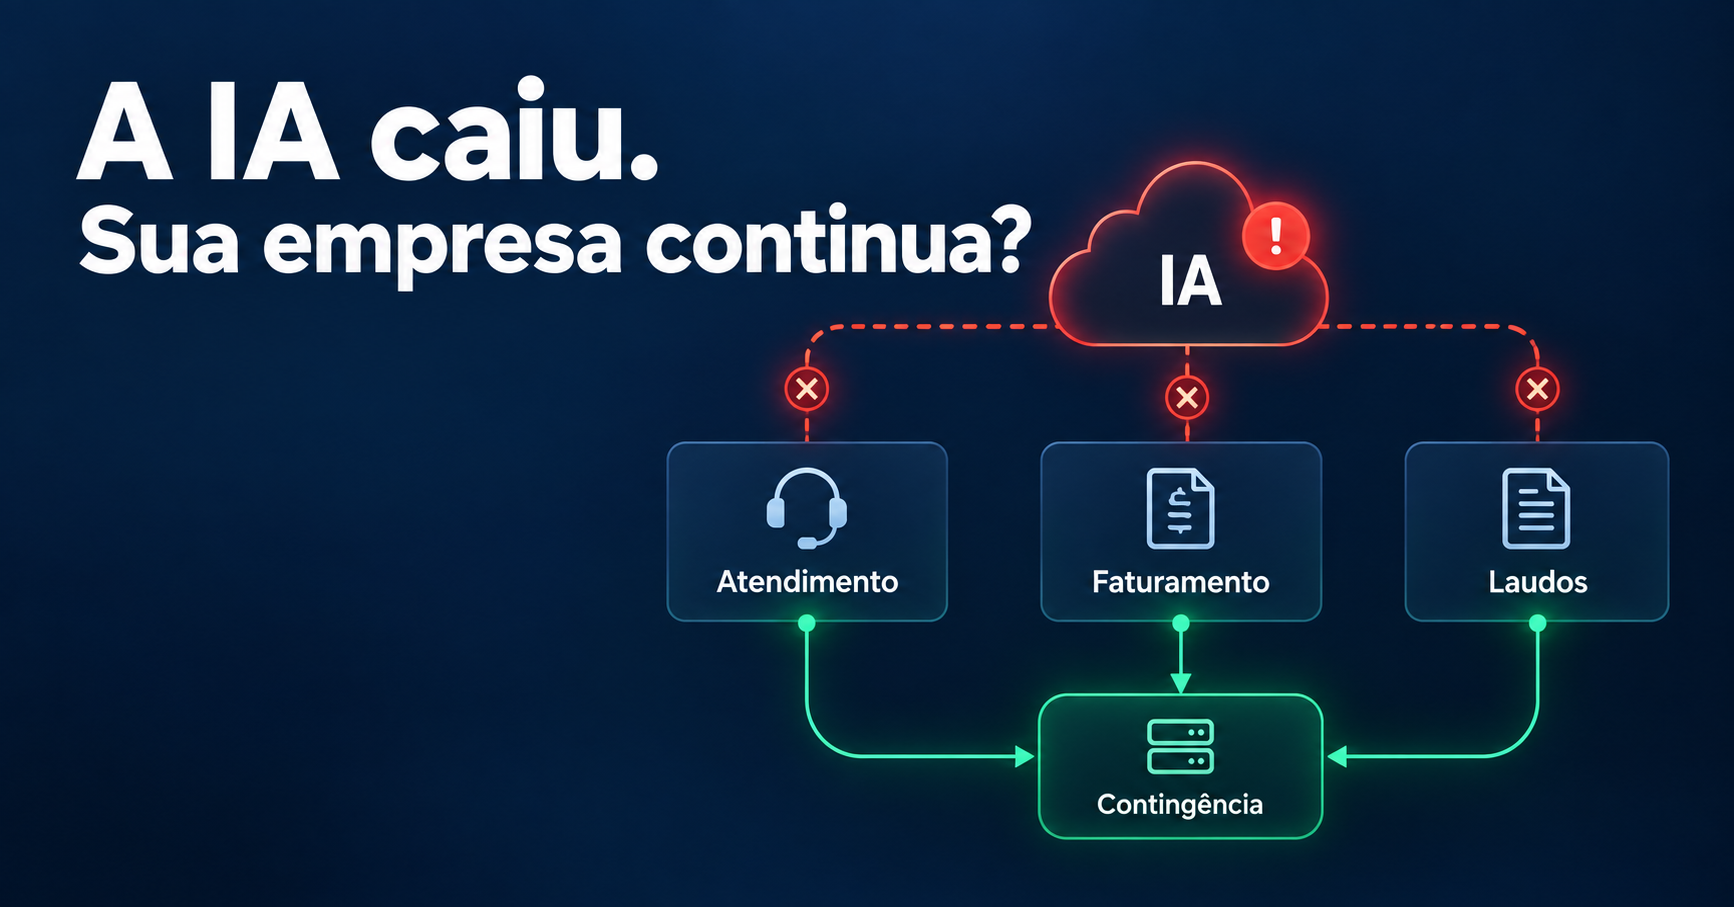
Se o seu provedor de inteligência artificial ficar indisponível agora, quais processos da sua empresa continuam funcionando?
O atendimento responde? O comercial registra oportunidades? O faturamento avança? A preparação de laudos continua? A equipe consegue manter os sistemas sem seu assistente de programação?
Essas perguntas precisam fazer parte da implantação de IA desde o início.
Os históricos públicos de incidentes de OpenAI e Anthropic registram erros e indisponibilidades. Esses registros não bastam para concluir que os serviços estão ficando menos confiáveis, mas demonstram que falhas precisam ser consideradas no planejamento.
Quanto mais a IA participa de processos essenciais, maior a importância de definir o que acontece quando ela deixa de responder.
Como uma falha de IA pode interromper o negócio
Uma indisponibilidade pode afetar uma tarefa isolada ou bloquear uma sequência inteira de atividades. Isso depende de como o sistema foi construído.
Considere estes cenários possíveis:
| Área | Possível impacto |
|---|---|
| Comercial | Um agente SDR deixa de responder, qualificar leads, fazer ligações ou agendar reuniões. |
| Atendimento | Clientes ficam sem resposta ou sem encaminhamento para uma pessoa. |
| Faturamento | Uma classificação ou conferência por IA bloqueia a emissão de documentos. |
| Saúde e diagnóstico | Transcrição, extração de dados ou preparação de rascunhos de laudos acumula pendências antes da revisão profissional. |
| Logística | Documentos e exceções aguardam análise, atrasando liberações. |
| Seguros | A triagem de sinistros e a análise documental ficam represadas. |
| Financeiro | Conciliações, conferências e encaminhamentos de cobrança deixam de avançar. |
| Desenvolvimento | A equipe perde produtividade e pode ter dificuldade para manter código que não compreende suficientemente. |
Esses exemplos ilustram riscos de dependência. Não são relatos de incidentes específicos nessas empresas ou setores.
Também é importante distinguir duas situações: usar IA para desenvolver um sistema e depender de IA para executar esse sistema.
Um software escrito com apoio de vibe coding pode funcionar normalmente durante uma falha do assistente. A dependência operacional aparece quando o produto chama modelos durante seu funcionamento. Existe ainda uma dependência da equipe quando ela precisa do assistente para entender, corrigir ou manter o código.
Muitas integrações ampliam o alcance de uma falha
Um agente de atendimento pode depender de um modelo, uma plataforma de automação, um CRM, um canal de mensagens, telefonia, agenda e banco de dados.
O modelo pode estar funcionando, mas o agente continuar indisponível porque a plataforma que coordena essas integrações parou. Da mesma forma, trocar o modelo não recupera uma ligação se o serviço de telefonia estiver fora do ar.
A documentação de arquitetura da Microsoft destaca que a camada de orquestração coordena contexto, chamadas de modelos e ferramentas; falhas nessa camada podem bloquear o sistema inteiro. Microsoft — arquitetura de aplicações de IA.
Por isso, mapear dependências é essencial. Cada etapa precisa ter uma resposta para três perguntas:
- O que acontece se ela falhar?
- Quais atividades podem continuar?
- Como o trabalho será retomado?
Por que tantas empresas não têm fallback?
Minha leitura é que muitos projetos são avaliados primeiro pela capacidade de funcionar em condições favoráveis.
A demonstração mostra o agente atendendo, consultando dados e executando tarefas. O orçamento destaca economia e produtividade. A continuidade recebe atenção depois — algumas vezes, apenas após a primeira interrupção.
Existem obstáculos concretos.
Manter uma alternativa custa dinheiro. É preciso integrar, testar, monitorar e manter capacidade disponível.
O sistema pode estar muito ligado a um fornecedor. Prompts, ferramentas, memória e fluxos foram adaptados ao comportamento de um modelo específico.
A responsabilidade pode estar fragmentada. O provedor responde pelo serviço; o integrador, pela automação; a empresa, pelo atendimento e pelos prejuízos. Alguém precisa assumir a continuidade do processo completo.
O procedimento manual pode ter perdido capacidade. Ter uma instrução documentada não significa que a equipe consiga absorver a demanda quando a automação para.
O SLA pode ser confundido com continuidade. Uma compensação contratual não recupera automaticamente oportunidades comerciais nem executa tarefas pendentes.
A decisão deve comparar o custo da contingência com o impacto da interrupção.
Usar outra IA como fallback resolve?
Uma segunda IA pode reduzir a dependência de um único provedor. Entretanto, a troca precisa ser validada.
Modelos diferentes podem interpretar instruções, selecionar ferramentas e produzir respostas de maneiras diferentes. Mesmo um único modelo apresenta variação entre execuções, algo que torna a avaliação de agentes especialmente importante. Anthropic — avaliação de agentes de IA.
Nem toda diferença é um problema.
No atendimento, “Qual horário funciona para você?” e “Qual desses horários você prefere?” podem cumprir a mesma função.
Já oferecer um horário inexistente, interpretar um desconto de outra maneira ou repetir uma cobrança são diferenças operacionais que exigem controle.
O fallback precisa preservar os critérios de qualidade e as regras do negócio. Não precisa reproduzir exatamente as mesmas palavras.
Isso exige casos de teste representativos, validação de saídas e limites claros para as ações que o modelo pode executar.
O que o MCP pode fazer pelo fallback de IA?
O Model Context Protocol, ou MCP, padroniza a comunicação de aplicações de IA com ferramentas e fontes de contexto. Ele permite disponibilizar recursos, ferramentas e modelos de prompts por uma interface comum. Documentação oficial do MCP.
Essa padronização pode facilitar a troca de modelo. Em vez de reconstruir cada integração, aplicações compatíveis podem acessar as mesmas ferramentas de CRM, agenda, consulta documental ou cálculo.
Também pode ajudar a preservar resultados de negócio quando as regras são executadas por ferramentas.
Imagine uma negociação de veículo em que o preço considerado seja o valor da FIPE menos 10%.
Se o cálculo depender apenas de uma instrução no prompt, o modelo precisará interpretar a regra e encontrar os dados corretos.
Uma ferramenta pode consultar a fonte definida, aplicar o desconto em código e devolver o resultado. Com os mesmos parâmetros e os mesmos dados, o cálculo pode ser consistente, independentemente de qual modelo o solicitou.
O MCP oferece a interface para essa ferramenta. A consistência vem da implementação da função, da qualidade dos dados e dos controles da aplicação.
O que o MCP não garante
O protocolo, sozinho, não garante que dois modelos:
- Escolham a mesma ferramenta.
- Preencham os parâmetros corretamente.
- Interpretem a resposta da mesma forma.
- Recebam contexto equivalente.
- Retomem uma tarefa exatamente do ponto em que parou.
A especificação descreve ferramentas cuja seleção pode ficar a cargo do modelo. A aplicação precisa controlar etapas obrigatórias quando o processo exigir essa garantia. MCP — ferramentas.
O MCP também não torna automaticamente disponíveis o servidor que oferece a ferramenta ou o sistema acessado por ela.
Uma arquitetura pode combinar MCP para integração, orquestração para troca de provedor e regras em código para decisões que precisam ser previsíveis.
Trocar de provedor exige preservar o estado
Considere um agente que envia uma solicitação de cobrança. A conexão cai antes de ele receber a confirmação.
A cobrança falhou ou foi executada?
Se o modelo de reserva repetir a ação sem verificar, pode gerar duplicidade. O mesmo risco existe em agendamentos, pedidos e envio de documentos.
É necessário registrar operações, consultar seu estado e usar mecanismos que impeçam repetir a mesma ação por engano.
O contexto da conversa também precisa estar disponível fora de uma dependência exclusiva do provedor principal. Caso contrário, o substituto pode receber apenas parte do histórico.
Recuperação envolve saber o que foi solicitado, o que foi executado e o que permanece pendente.
Dois provedores podem compartilhar um ponto de falha
Duas IAs acessadas pela mesma plataforma de automação continuam dependendo dessa plataforma.
Uma configuração alternativa também pode falhar por falta de limite de uso, credenciais inadequadas ou capacidade insuficiente para absorver o tráfego.
A documentação da Microsoft apresenta estratégias de múltiplos destinos e regiões, considerando disponibilidade e cotas. Essas soluções também precisam proteger a infraestrutura responsável por encaminhar as chamadas. Microsoft — gateways para modelos de IA.
Ter acesso a outro modelo é um começo. A capacidade de utilizá-lo durante uma falha precisa ser demonstrada.
Quando o fallback é difícil ou caro?
Algumas dependências permitem substituição relativamente simples. Outras exigem adaptação extensa.
| Dependência | Por que a troca pode ser difícil |
|---|---|
| Modelo especializado ou ajustado | O substituto precisa atingir desempenho aceitável para a tarefa. |
| Busca baseada em embeddings | Trocar o modelo de embeddings pode exigir reindexação e nova validação das buscas. |
| Voz em tempo real | Telefonia, transcrição, geração de resposta e síntese precisam manter compatibilidade e latência adequada. |
| Agente com tarefas em andamento | Arquivos, memória e ações parcialmente executadas dificultam a retomada. |
| Dados com restrições de tratamento | O fornecedor alternativo precisa estar previamente autorizado para receber esses dados. |
| Serviços externos essenciais | Outra IA não substitui um sistema fiscal, uma rede de pagamentos ou um canal de comunicação indisponível. |
Trocar o modelo que responde não exige necessariamente trocar os embeddings. As duas dependências podem ser separadas, reduzindo o alcance da mudança.
Um modelo executado localmente pode servir como alternativa em alguns casos, mas também exige infraestrutura, capacidade e avaliação de qualidade. Sua viabilidade depende da tarefa.
Em determinadas operações, a recuperação imediata terá um custo desproporcional. Nesse caso, a empresa precisa definir quanto tempo pode esperar e qual serviço reduzido consegue oferecer.
Fallback pode ser uma pessoa, uma regra ou uma fila
A contingência pode assumir diferentes formas:
Atendimento humano: transferência com o histórico disponível.
Regras fixas: continuidade de casos simples com respostas aprovadas e consultas estruturadas.
Fila recuperável: registro de solicitações para processamento posterior, com prazo comunicado.
Operação reduzida: manutenção das funções essenciais enquanto etapas adicionais aguardam.
Suspensão controlada: bloqueio temporário de ações que não podem ser executadas com segurança.
A alternativa manual precisa ter capacidade real. Se uma equipe consegue atender apenas uma fração da demanda automatizada, será necessário priorizar casos e comunicar espera.
Em processos críticos, uma pausa registrada e recuperável pode ser mais adequada do que continuar com um modelo que não foi validado para aquela atividade.
Como testar o plano de continuidade
Uma verificação útil precisa simular mais que a ausência completa de resposta.
Inclua demora excessiva, erros intermitentes, limite de uso, falha de ferramenta e perda de conexão após uma ação.
Observe se:
- O sistema identifica a falha em tempo aceitável.
- A alternativa tem capacidade para receber a demanda.
- As regras comerciais continuam válidas.
- O histórico e as tarefas pendentes são preservados.
- As ações não são duplicadas.
- A equipe e o cliente recebem informações claras.
- A volta ao funcionamento normal ocorre sem perder trabalho.
Defina também o tempo máximo tolerável de interrupção e a perda de informação aceitável. Esses limites ajudam a escolher uma contingência compatível com o impacto do processo.
O retorno ao provedor principal merece planejamento: tarefas podem estar em andamento no sistema alternativo.
Perguntas frequentes sobre fallback e MCP
O MCP faz a troca automática entre provedores de IA?
O protocolo não oferece, por si só, uma garantia de troca automática. Essa lógica pode ser implementada na aplicação, em um gateway ou em um serviço que use MCP, mas precisa ser projetada e testada.
O mesmo prompt deve produzir respostas idênticas?
Não é uma expectativa adequada para modelos generativos. A avaliação deve verificar se as respostas cumprem os mesmos requisitos. Quando um resultado precisa ser exato, cálculos e regras devem ser executados por componentes controlados.
Preciso contratar dois provedores?
Depende do impacto da interrupção. Uma alternativa humana, uma fila ou regras fixas podem ser suficientes. Em outros processos, múltiplos provedores podem justificar o custo.
Ter backup dos dados resolve?
O backup ajuda na recuperação de informações. Ele não substitui capacidade de processamento, integrações disponíveis nem procedimentos para continuar o atendimento.
A continuidade precisa acompanhar a automação
A IA pode acelerar processos e ampliar a capacidade das empresas. Cada nova dependência essencial também precisa de um plano para falhas.
Antes de automatizar, defina quem assume, o que continua, o que aguarda e como o trabalho será retomado.
MCP, múltiplos provedores e ferramentas compartilhadas podem contribuir. A continuidade depende de como esses componentes são implementados, avaliados e operados.
Se a IA cair hoje, sua empresa já sabe como continuar?
Continue lendo
- O custo invisível da Agentic AI
- Microsoft Scout: o agente de IA autônomo
- Alta disponibilidade no MySQL: o que é e como fazer
- PostgreSQL: alta disponibilidade e replicação
📘 Continuidade começa no banco de dados. Registrar operações, consultar estado e evitar duplicidade são fundamentos de banco. No livro Aprendendo MySQL — Prática, Teoria, Laboratórios, Desafios e Projetos você pratica isso em 10 laboratórios guiados e 277 exercícios. Baixe a degustação gratuita e veja por dentro.
Curtiu? Me siga no Instagram e no LinkedIn — tem mais conteúdo sobre IA, dados e arquitetura por lá.
Sobre o autor — Alexandre Almeida é DBA e arquiteto de dados há mais de 25 anos, autor do livro Aprendendo MySQL. Fontes citadas: OpenAI Status, Anthropic Status, Microsoft Learn (Azure Well-Architected e gateways de IA), Anthropic Engineering e a especificação oficial do Model Context Protocol.